注意力机制可视化
Transformer 是当今多数大语言模型的核心结构,注意力机制是其关键部分。本实验把模型处理一句话时各词元之间的注意力权重画成可视图,让你直观看到模型在计算某个词时更“关注”句中哪些词。
在实验室中查看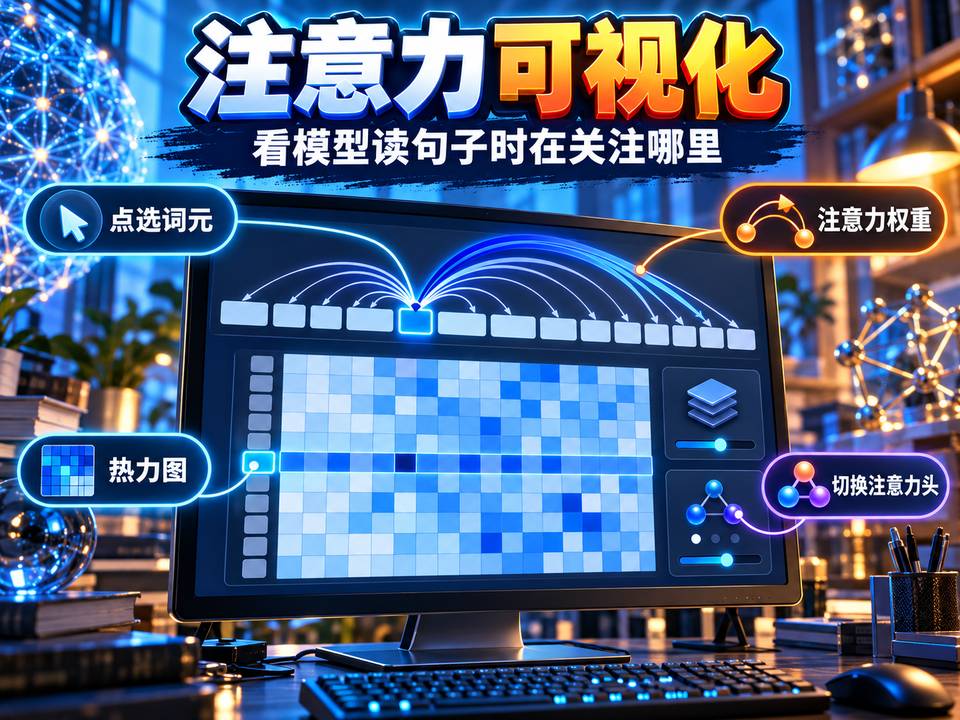
实验目的
理解注意力权重的含义,了解注意力机制如何利用上下文信息。
实验原理
注意力机制让模型处理某个词元时,给句中各词元分配不同权重,权重越大,表示该词元对当前结果的影响越大。权重由查询向量 Q 与键向量 K 的相似度经 softmax 归一化得到,再对值向量 V 加权求和:Attention(Q,K,V) = softmax(QK^T/√d_k)V。
实验器材
- 一句示例文本
- 分词后的词元序列
- 注意力权重可视图(如热力图或连线)
- 词元选择操作
- 层或注意力头的切换选项(如页面提供)
实验步骤
- 选择或输入一句话,查看分词后的词元。
- 选中某个词元,观察它对其他词元的注意力权重。
- 比较颜色深浅或连线粗细,找出权重较大的词元。
- 若页面提供,切换不同的层或注意力头再观察。
- 换一句话,看权重分布有什么变化。
实验现象与结论
同一个词元对句中不同词元的权重不同,权重大的位置颜色更深或连线更粗。不同的层或注意力头,关注的位置可能各不相同。结论:注意力机制让模型在每个位置根据上下文动态分配关注,这是模型理解词语间关系的重要手段。
常见问题
- 注意力权重高,就说明模型“理解”了这个词吗?
- 不能这样直接认定。权重只是观察模型内部计算的一条线索,不等同于理解。
- 公式里为什么要除以 √d_k?
- 维度较大时点积容易很大,除以 √d_k 可避免 softmax 结果过于极端,使训练更稳定。
同一课题的其他实验 ·
 生活里的人工智能在日常生活场景中找一找人工智能,认识语音助手、人脸识别、导航等常见 AI 应用,并体会它们…
 图灵测试小游戏:猜猜对面是人还是机器通过文字交流判断对面是真人还是机器,体验图灵测试的思路,思考机器表现得“像人”是否就等于有…
 机器怎么“看”一张图把一张图片放大到像素,观察每个小格对应的数字,了解计算机是如何把图像变成数据来“看”的。
 规则与学习:让机器变聪明的两种方法对比“人工编写规则”和“从数据中学习”两种方法,体会机器是如何完成分类、判断等任务的。
 人工智能发展简史按时间顺序浏览人工智能发展中的重要事件,了解它的起步、起伏与近年快速发展的原因。
 AI 能做什么、不能做什么通过判断一系列任务是否适合交给人工智能,认识 AI 的擅长之处与局限,学会理性看待它。
 给图片贴标签:认识数据标注动手给图片贴上类别标签,体会机器学习需要“带答案”的数据,了解标签对机器识别的作用。
 声音变成波形观察声音在屏幕上显示成的波形,了解响度、音调与波形的关系,理解声音如何变成计算机能处理的数…
相关搜索:注意力机制可视化 · Transformer 注意力权重 · self-attention 是什么 · 注意力热力图 · 大语言模型 高中 注意力 · Q K V 注意力计算 · 注意力机制可视化互动课件 · 注意力机制可视化虚拟仿真实验