大语言模型:从预训练到对齐
大语言模型并不是一开始就会“好好回答问题”。它通常先在大规模文本上预训练,学会预测下一个词;再用指令数据微调,学会按要求作答;最后通过人类偏好反馈进行对齐,让回答更有用、更安全。本演示帮助高中生理清这条训练主线。
在实验室中查看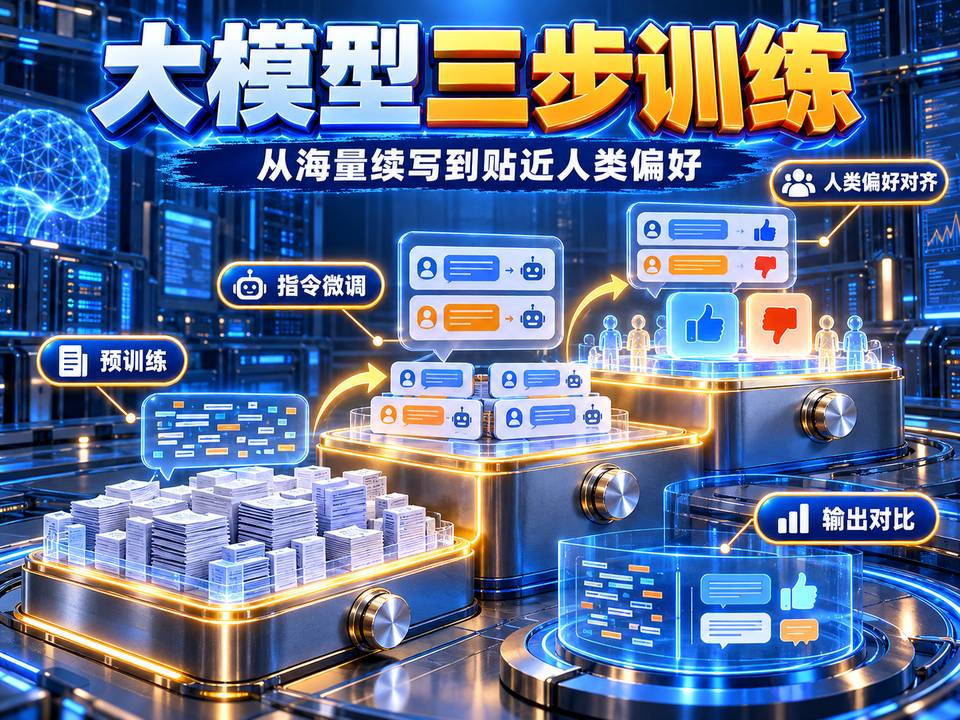
实验目的
理解大语言模型三个训练阶段的目标,以及对齐的意义。
实验原理
预训练:在海量文本上以“预测下一个词”为目标训练参数,学到语言和知识的统计规律。指令微调:用“指令—回答”示例继续训练,使模型学会遵循指令。对齐:利用人类对回答的偏好反馈(如基于人类反馈的强化学习)调整模型,使输出更符合人类期望和安全要求。
实验器材
- 预训练阶段(海量文本语料)
- 指令微调阶段(指令—回答示例)
- 对齐阶段(人类偏好反馈)
- 各阶段模型的输出对比
- 互动演示的阶段切换控件
实验步骤
- 先看预训练阶段,了解训练数据和“预测下一个词”的目标。
- 观察只经过预训练的模型面对提问时的输出特点。
- 进入指令微调阶段,查看指令—回答示例的作用。
- 进入对齐阶段,了解人类偏好反馈如何调整回答。
- 对比三个阶段的输出,概括各阶段的作用。
实验现象与结论
只经过预训练的模型擅长续写文本,但不一定按提问作答;指令微调后更能遵循要求;对齐后回答更贴近人类偏好,更有用、更安全。结论:三个阶段目标不同、依次叠加,共同决定模型的最终表现。
注意事项
- 对齐不能保证模型不出错,重要信息仍需核实。
常见问题
- 预训练和微调有什么区别?
- 预训练用海量文本学习语言规律;微调用较少的针对性数据继续训练,使模型更会完成特定任务或遵循指令。
- 为什么大模型还需要对齐?
- 预训练只学会“像人写的文字”,不保证有用、无害、诚实。对齐用人类偏好引导输出,使回答更符合期望。
同一课题的其他实验 ·
 生活里的人工智能在日常生活场景中找一找人工智能,认识语音助手、人脸识别、导航等常见 AI 应用,并体会它们…
 图灵测试小游戏:猜猜对面是人还是机器通过文字交流判断对面是真人还是机器,体验图灵测试的思路,思考机器表现得“像人”是否就等于有…
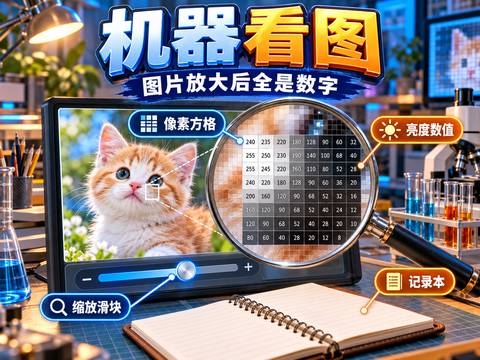 机器怎么“看”一张图把一张图片放大到像素,观察每个小格对应的数字,了解计算机是如何把图像变成数据来“看”的。
 规则与学习:让机器变聪明的两种方法对比“人工编写规则”和“从数据中学习”两种方法,体会机器是如何完成分类、判断等任务的。
 人工智能发展简史按时间顺序浏览人工智能发展中的重要事件,了解它的起步、起伏与近年快速发展的原因。
 AI 能做什么、不能做什么通过判断一系列任务是否适合交给人工智能,认识 AI 的擅长之处与局限,学会理性看待它。
 给图片贴标签:认识数据标注动手给图片贴上类别标签,体会机器学习需要“带答案”的数据,了解标签对机器识别的作用。
 声音变成波形观察声音在屏幕上显示成的波形,了解响度、音调与波形的关系,理解声音如何变成计算机能处理的数…
相关搜索:大语言模型训练过程 · 预训练微调对齐 · RLHF是什么 · 大模型对齐 高中 · 指令微调是什么 · 大语言模型:从预训练到对齐互动课件 · 大语言模型:从预训练到对齐虚拟仿真实验